Plateformes
Le problème n’est pas la qualité de vos données, c’est l’absence de propriétaire.
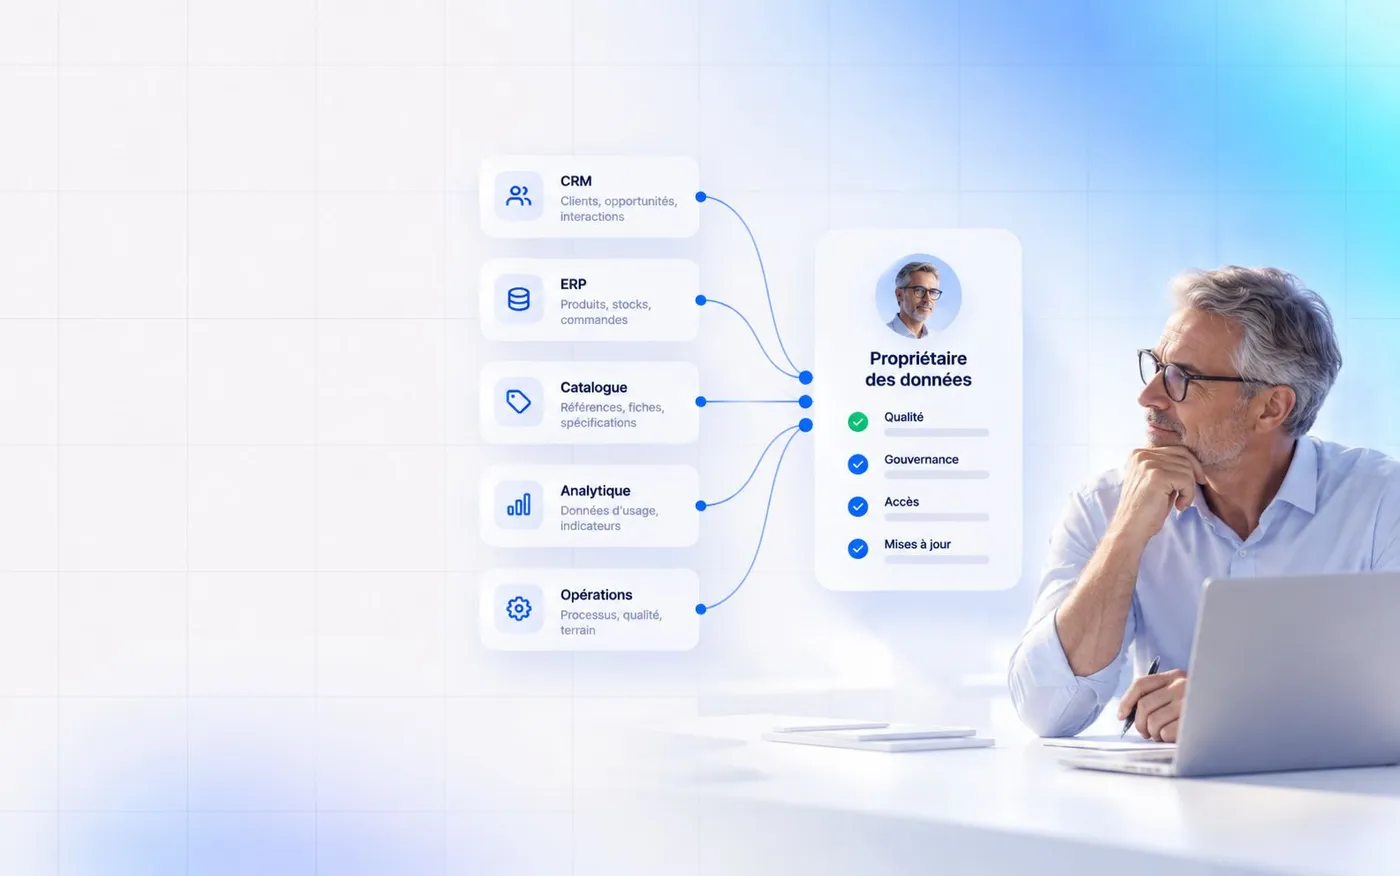
Les initiatives de qualité des données commencent presque toujours par un constat juste et se terminent presque toujours de la même façon : une amélioration réelle, puis un retour progressif à l’état antérieur. Le problème n’est pas la méthode de nettoyage. C’est qu’un nettoyage est un projet, alors que la qualité est une responsabilité continue.
Le cycle du grand nettoyage
La séquence est presque toujours identique. Une direction constate des écarts entre deux rapports. Un projet de qualité des données est lancé. Des doublons sont fusionnés, des règles de validation sont ajoutées, des référentiels sont alignés. Six mois plus tard, les chiffres concordent enfin.
Puis l’équipe projet se dissout. Un nouveau canal de vente apparaît avec son propre format d’adresse. Un service crée un champ libre pour contourner une contrainte trop rigide. Une intégration ajoute des enregistrements sans passer par les règles prévues. Dix-huit mois après la fin du chantier, les écarts sont revenus, et l’organisation conclut généralement qu’il faut refaire le nettoyage.
La conclusion est erronée, parce qu’elle traite un phénomène continu avec une réponse ponctuelle. Aucune donnée ne reste juste par elle-même : elle reste juste parce que quelqu’un est responsable de sa justesse, et que cette personne a l’autorité correspondante.
Où se situe réellement la propriété
La réponse spontanée est de confier la donnée à l’équipe technique qui héberge la base. C’est la pire option disponible : cette équipe connaît le stockage, pas la signification. Elle peut garantir qu’un champ est rempli, jamais qu’il est correct.
Les travaux sur le maillage de données, publiés par Zhamak Dehghani, formulent le principe inverse : la propriété appartient au domaine métier qui produit la donnée et en comprend le sens. L’équipe qui gère les contrats possède la donnée contractuelle. Celle qui gère la logistique possède les états d’expédition. Chacune expose sa donnée aux autres comme un produit, avec des attentes explicites de qualité et de disponibilité.
Ce déplacement paraît bureaucratique et il est très concret. Il remplace une question insoluble — « pourquoi les données sont-elles fausses ? » — par une question adressable : « qui décide de ce qu’est un client actif, et à qui s’adresse-t-on quand la définition ne tient plus ? ».
Une donnée sans propriétaire n’appartient pas à tout le monde. Elle appartient au dernier système qui l’a modifiée.
Reconnaître un problème de propriété
La plupart des symptômes attribués à la qualité des données décrivent en réalité une absence de responsable identifiable.
| Symptôme observé | Interprétation habituelle | Ce qu’il signale réellement |
|---|---|---|
| Deux rapports donnent des chiffres différents | Erreur de calcul | Deux définitions coexistent, aucune ne fait autorité |
| Un champ obligatoire est rempli n’importe comment | Manque de rigueur des équipes | La contrainte ne correspond pas au travail réel |
| Chaque équipe conserve son propre extrait | Habitude locale | Personne ne garantit la source commune |
| Une correction est annulée le lendemain | Problème de synchronisation | Deux systèmes se croient tous deux autoritaires |
Ce qu’un outil de gouvernance ne remplacera pas
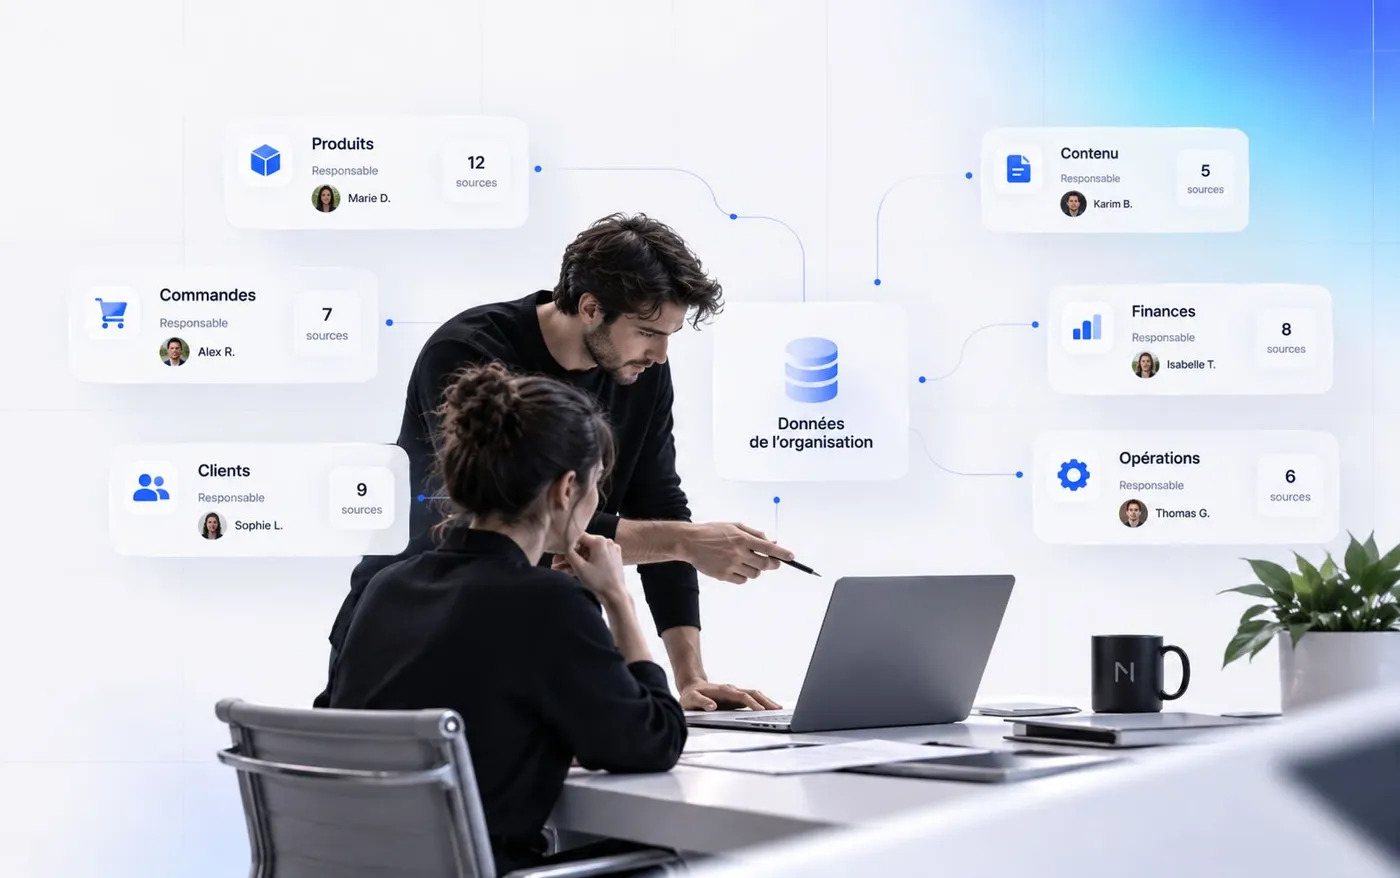
Les plateformes de gouvernance — catalogues, lignage, classification — sont utiles et souvent nécessaires à l’échelle. Elles ne créent cependant aucune responsabilité : elles l’enregistrent. Un catalogue déployé sans propriétaires désignés produit un inventaire exhaustif de données dont personne ne répond, ce qui améliore surtout la visibilité du problème.
L’ordre qui fonctionne est inverse de celui des projets habituels. On désigne d’abord un responsable par domaine, avec un mandat écrit. On documente ensuite les définitions qui font autorité, y compris celles qui déplaisent à une partie de l’organisation. On outille enfin, pour rendre ces décisions consultables et vérifiables.
- Nommer un responsable par domaine de données, côté métier, avec l’autorité de trancher une définition.
- Écrire les définitions qui font autorité, et la liste des systèmes qui doivent s’y conformer.
- Déclarer un niveau de service : fraîcheur attendue, délai de correction, mode de signalement.
- Mesurer les écarts au niveau du domaine, et les rapporter au responsable, pas à l’équipe technique.
Une organisation qui franchit cette étape découvre souvent que ses données n’étaient pas mauvaises : elles étaient orphelines. Les définitions existaient, dispersées dans des têtes et des chiffriers, sans personne pour arbitrer lorsqu’elles divergeaient. C’est cet arbitrage, et non l’outil, qui tient la qualité dans le temps.
Sources et références
Une expertise liée à ce sujet
Découvrir l’expertiseUn enjeu similaire dans votre organisation ?
Échanger sur votre projet