IA
Mettre un humain dans la boucle ne suffit pas à contrôler une IA.
La plupart des projets d’intelligence artificielle en entreprise prévoient une supervision humaine. Peu précisent ce que cette personne peut réellement faire, avec quelles informations et en combien de temps. C’est pourtant là que se joue la fiabilité du dispositif.
Une file d’attente qui ne valide plus rien
Une équipe de service à la clientèle met en service un assistant qui rédige les réponses aux demandes courantes. La règle est claire dès le départ : aucune réponse n’est envoyée sans relecture humaine. Personne ne conteste ce principe, et il figure dans la note d’approbation du projet.
Les premières semaines se déroulent comme prévu. Le volume est faible, les propositions sont lues attentivement, une sur trois est corrigée. Trois mois plus tard, l’assistant traite quatre cents demandes par jour, deux personnes assurent la relecture, et la qualité apparente des propositions est élevée. Le temps médian passé sur une réponse est tombé sous les dix secondes. Le taux de correction approche de zéro.
Sur le papier, le contrôle humain est intact : chaque envoi porte l’approbation d’une personne identifiée. Dans les faits, la file de validation est devenue un tampon. La question n’est pas de savoir si les équipes font mal leur travail — elles font exactement ce que le dispositif leur permet de faire.
L’erreur n’est pas d’automatiser, c’est de traiter la validation comme une garantie
Une personne placée devant un système qui a raison la plupart du temps finit par lui donner raison. Ce phénomène porte un nom — le biais d’automatisation — et il n’est pas un défaut d’attention individuelle : c’est une conséquence prévisible de la conception du poste de travail.
Le règlement européen sur l’intelligence artificielle en tire des conséquences concrètes. Son article 14 exige que les systèmes à haut risque soient conçus pour permettre une supervision humaine effective, et il précise ce que cela suppose : que la personne comprenne les capacités et les limites du système, qu’elle reste consciente de cette tendance à la surconfiance, qu’elle interprète correctement les résultats, qu’elle puisse décider de ne pas les utiliser, de les écarter ou de les annuler, et qu’elle puisse interrompre le système. Le même article demande que ces mesures soient proportionnées au risque, au niveau d’autonomie et au contexte d’usage.
La plupart des organisations d’ici ne sont pas assujetties à ce texte. Il reste qu’il formule une exigence de conception qui vaut bien au-delà de son champ d’application : la supervision n’est pas une case à cocher, c’est une capacité qu’il faut construire. Et une capacité se reconnaît à quatre conditions.
- L’autorité : refuser une proposition doit être une décision normale, pas un incident à justifier.
- Le temps : la cadence attendue doit permettre une lecture réelle, pas seulement un clic.
- L’information : les éléments nécessaires à la décision doivent être visibles au moment de la décision, sans changement d’outil.
- La trace : les refus et les corrections doivent être enregistrés, sinon personne ne saura si le contrôle fonctionne.
Une personne qui n’a ni le temps ni l’autorité de refuser n’est pas un contrôle. Elle est un témoin.
Classer les décisions avant de classer les modèles
La discussion sur la supervision se tient presque toujours au niveau du projet : « cet assistant sera-t-il supervisé ? » C’est le mauvais niveau. Un même assistant produit des décisions dont les conséquences n’ont rien de comparable : proposer un libellé de réponse, appliquer un crédit, refuser une réclamation, modifier un dossier client.
Trois questions suffisent à trancher, et elles ne portent ni sur la technologie ni sur la performance du modèle.
| Question | Ce qu’elle mesure | Ce qu’elle change |
|---|---|---|
| La décision est-elle réversible ? | Le coût d’annuler après coup | Une erreur réversible tolère un contrôle par échantillon |
| Est-elle visible à l’extérieur ? | L’exposition client ou réglementaire | Une sortie diffusée engage l’organisation immédiatement |
| Que coûte le pire cas plausible ? | Le préjudice maximal, pas le cas moyen | Un pire cas élevé justifie une validation systématique |
La performance moyenne d’un modèle est une mauvaise boussole ici. Un système exact à 97 % reste inacceptable si les 3 % restants produisent un refus de service injustifié, et parfaitement acceptable s’ils produisent une formulation maladroite corrigée en aval.
Quatre régimes, pas deux
Le débat se présente souvent comme un choix binaire entre automatisation complète et validation systématique. Dans les faits, quatre régimes couvrent l’essentiel des situations, et un même processus en combine généralement plusieurs.
- Exécution directe : décisions réversibles, internes, à faible conséquence. Le contrôle se fait par la mesure agrégée, pas par la relecture.
- Contrôle par échantillon : un pourcentage défini de cas est relu, avec révision du taux dès qu’un écart apparaît. Utile quand le volume rend la relecture intégrale illusoire.
- Validation obligatoire : rien ne sort sans décision humaine explicite, et la cadence de travail est dimensionnée en conséquence. Réservé aux décisions difficilement réversibles ou visibles à l’externe.
- Hors périmètre : exceptions contractuelles, situations sensibles, dossiers incomplets. Le système n’émet aucune proposition et transmet directement le dossier.
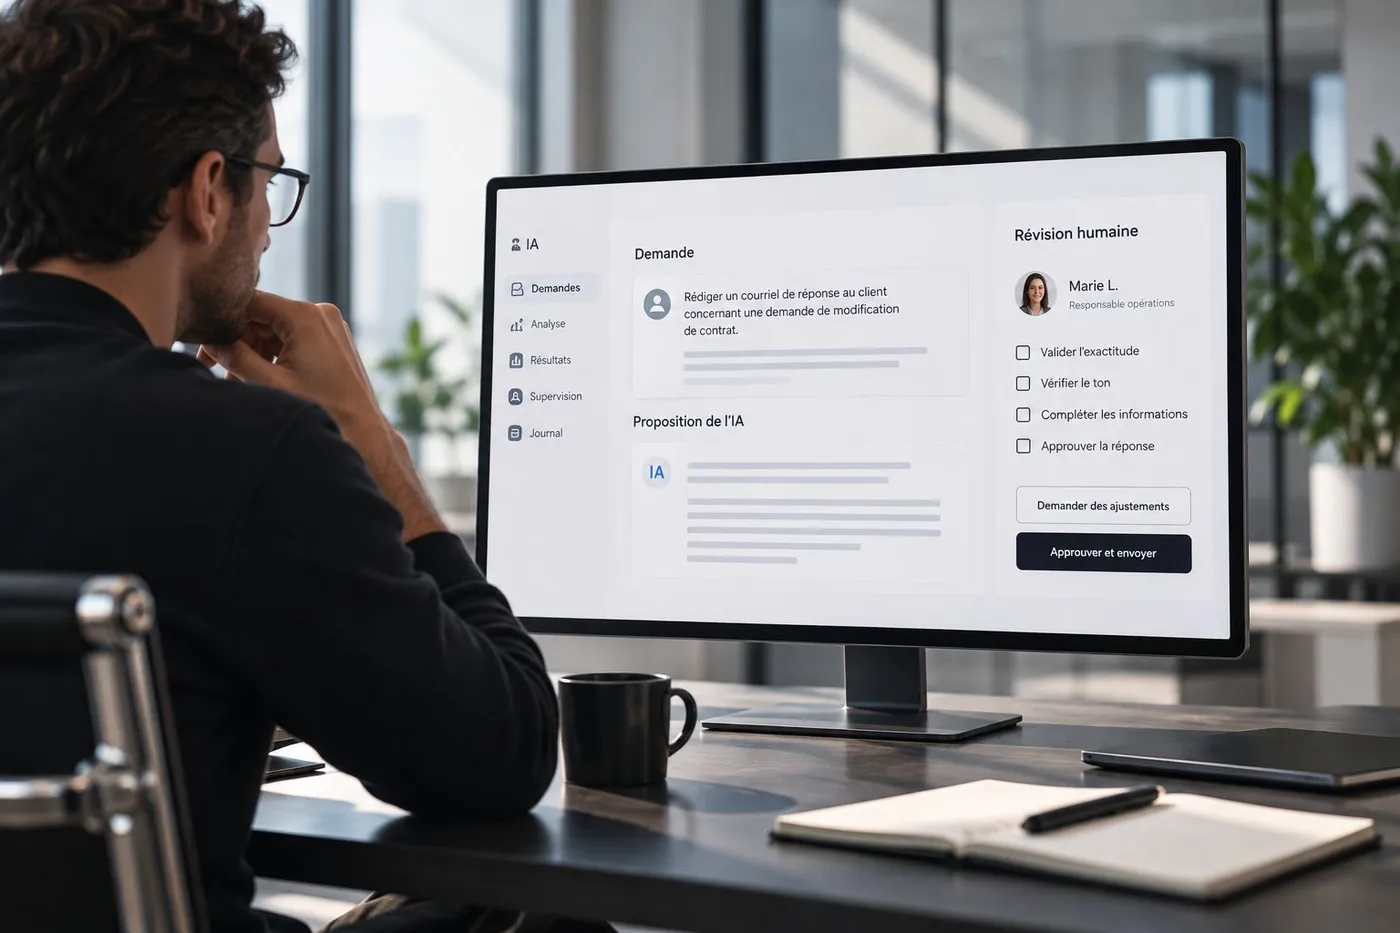
Le quatrième régime est celui qu’on oublie le plus souvent, et c’est celui qui protège le mieux. Nommer explicitement ce que le système ne traite pas évite les réponses approximatives sur les dossiers qui comptent le plus.
Vérifier que le contrôle fonctionne encore
Un régime de supervision se dégrade silencieusement. Il est décidé au lancement, puis le volume augmente, les effectifs changent, la confiance s’installe, et plus personne ne revient sur le réglage initial. Quelques indicateurs suffisent à détecter cette dérive, à condition d’être regardés régulièrement.
- Le taux de modification des propositions : s’il tend vers zéro, le contrôle a cessé de s’exercer.
- Le temps médian passé par dossier, comparé au temps nécessaire pour lire l’information utile.
- La proportion de cas escaladés hors du périmètre automatisé, et leur évolution.
- Les écarts détectés en aval — réclamations, corrections manuelles, reprises — qui auraient dû être arrêtés à la validation.
Le cadre de gestion des risques liés à l’IA publié par le NIST organise cette discipline en quatre fonctions — gouverner, cartographier, mesurer, gérer — et place explicitement l’efficacité des mécanismes de supervision parmi les objets à mesurer. L’idée à retenir est simple : l’existence d’un contrôle et son efficacité sont deux questions distinctes, et seule la seconde protège l’organisation.
Une intelligence artificielle utile en production n’est pas celle qui demande le moins d’intervention humaine. C’est celle dont on sait précisément quelles décisions elle prend seule, lesquelles elle prépare, lesquelles elle n’aborde pas — et comment on s’en assure.
Sources et références
Une expertise liée à ce sujet
Découvrir l’expertiseUn enjeu similaire dans votre organisation ?
Échanger sur votre projet